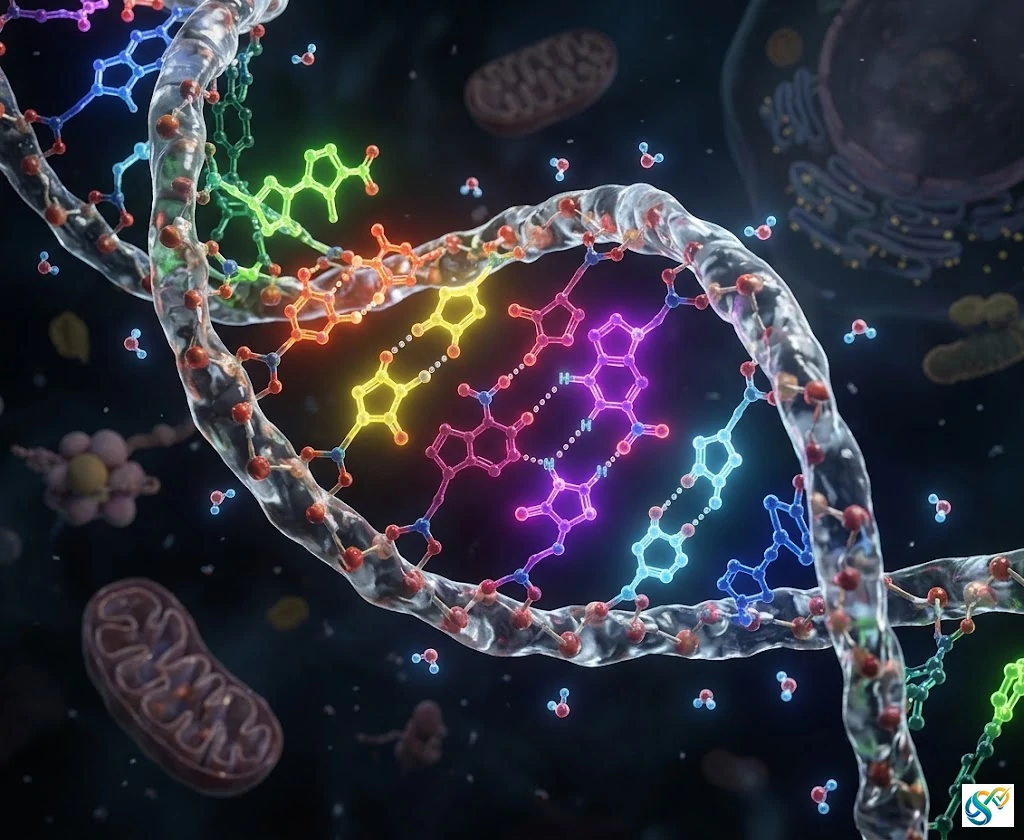
Tutta la vita conosciuta sul nostro pianeta si basa su un alfabeto genetico a quattro lettere: A (adenina), T (timina) o U (uracile), C (citosina) e G (guanina). Queste quattro molecole costituiscono il mattone fondamentale con cui la natura scrive le istruzioni per costruire ogni singola forma vivente. Un grande obiettivo della biologia sintetica è estendere questo alfabeto naturale creando nuove basi artificiali capaci di formare coppie di basi non naturali (UBP). Un sistema esteso a otto lettere, denominato sistema Hachimoji, introduce quattro nuove basi sintetiche, chiamate P, Z, B e S.
Per fare in modo che un alfabeto sintetico funzioni davvero all’interno delle cellule, non basta poter sintetizzare il DNA in laboratorio. Il macchinario cellulare deve essere in grado di leggere il DNA contenente le nuove lettere e trascriverlo in RNA senza commettere errori. Il motore molecolare responsabile di questo processo è l’RNA polimerasi. Gli studiosi hanno dimostrato che l’enzima RNA polimerasi del batterio Escherichia coli è perfettamente in grado di trascrivere l’alfabeto a otto lettere, dimostrando che le molecole sintetiche si comportano esattamente come quelle naturali.
Il funzionamento del codice genetico esteso
Il DNA funziona come un testo composto da parole composte da nucleotidi. Nel DNA naturale, le basi si accoppiano in modo specifico formando legami a idrogeno: la A si lega alla T e la C si lega alla G. Nel sistema esteso Hachimoji, si aggiungono due nuove coppie ortogonali:
-
Coppia P e Z: si legano in modo specifico rispettando la forma e le dimensioni standard delle coppie naturali.
-
Coppia B e S: formano la seconda coppia sintetica indipendente che aumenta la varietà chimica del materiale genetico.
Quando l’RNA polimerasi incontra una lettera sintetica sul filamento di DNA stampo, seleziona in modo selettivo ed efficiente la lettera sintetica complementare. Le analisi dei tempi di reazione indicano che l’incorporazione dei nucleotidi P e Z avviene con velocità confrontabili a quelle delle basi naturali G e C.
Soluzione chimica per la fedeltà di trascrizione
Durante le prime fasi di sperimentazione, è stato notato un problema di mancata fedeltà molecolare. La base Z tende a perdere un protone a pH fisiologico (un fenomeno chiamato deprotonazione) a causa della presenza di un gruppo nitro. La forma deprotonata della base Z assume una configurazione chimica simile alla citosina e finisce per legarsi erroneamente alla guanina (G).
Per superare questo errore, i ricercatori hanno progettato una variante chimica perfezionata della molecola, denominata Z*.
-
Sostituzione del gruppo nitro: il gruppo nitro è stato sostituito con un gruppo carbossammide.
-
Innalzamento del pKa: la modifica ha portato il pKa (l’indice che misura la tendenza a cedere protoni) da circa $7.8$ a un valore superiore a $10$.
-
Prevenzione della deprotonazione: il valore di pKa più elevato rende la molecola stabile e non soggetta a deprotonazione a pH neutro.
-
Eliminazione degli accoppiamenti errati: la presenza di Z* riduce in modo drastico gli accoppiamenti errati con la guanina, garantendo una fedeltà di trascrizione elevatissima.
Meccanismo di riconoscimento e struttura tridimensionale
Attraverso la crio-microscopia elettronica (cryo-EM), sono state determinate quattro strutture ad altissima risoluzione dell’enzima RNA polimerasi impegnato nella trascrizione di complessi contenenti dZ:PTP e dP:Z*TP.
Le immagini evidenziano una serie di passaggi molecolari precisi:
-
Posizionamento iniziale del nucleotide: la base sintetica entra nel sito attivo dell’enzima e forma una geometria del tutto analoga a quella delle coppie naturali di Watson-Crick.
-
Movimento del dominio S13: il dominio strutturale dell’enzima ruota di circa $-25^\circ$ e si sposta di $-26\text{ \AA}$ verso il sito attivo.
-
Chiusura del trigger loop: la regione dell’enzima chiamata trigger loop cambia forma ripiegandosi a elica per bloccare il nucleotide corretto.
-
Coordinazione dei metalli catalitici: due ioni di magnesio ($\text{Mg}^{2+}$) coordinano la catena dei tre fosfati assumendo una conformazione a sedia pronta per la reazione molecolare.
Approfondimenti tecnici e dettagli strutturali dal PDF
I dettagli forniti dalla ricerca strutturale ed enzimatica chiariscono i parametri molecolari, chimici e fisici:
-
Risoluzione Cryo-EM: le quattro strutture tridimensionali del complesso di allungamento della RNA polimerasi di E. coli sono state risolte a una risoluzione compresa tra $2.42\text{ \AA}$ e $2.75\text{ \AA}$.
-
Architettura del sito attivo e legami chimici: nel complesso dZ:PTP, il residuo M932 del trigger loop (TL) e il residuo T790 dell’elica ponte (Bridge Helix, BH) stabilizzano le basi nucleotidiche mediante interazioni idrofobiche. Il residuo H936 del TL forma un legame a idrogeno diretto con il fosfato $\beta$ del substrato PTP.
-
Interazione molecolare $\pi$-hole: la struttura ad alta risoluzione del complesso dZ:PTP evidenzia una rete di interazioni a tre direzioni mediata da una molecola d’acqua orientata specificamente. La molecola d’acqua dona un doppietto elettronico solitario verso la regione carente di elettroni (chiamata $\pi$-hole) situata sopra l’azoto del gruppo nitro della base dZ. La distanza tra l’acqua e l’azoto del gruppo nitro è pari a $2.62\text{ \AA}$, con uno spostamento laterale rispetto all’asse normale del piano di soli $0.64\text{ \AA}$.
-
Stabilizzazione della curvatura dell’elica ponte: la molecola d’acqua forma due legami a idrogeno supplementari con il gruppo carbonilico dello scheletro del residuo A787 e l’ammide dello scheletro del residuo A791 della BH. Questa rete molecolare stabilisce la conformazione piegata dell’elica ponte, favorendo il ripiegamento del trigger loop nello stato chiuso cataliticamente attivo.
-
Dinamica di popolamento degli stati conformazionali: nei dati crio-EM del complesso dZ:PTP, il $76.8\%$ delle particelle adotta una conformazione TL-closed e solo il $23.2\%$ rimane nello stato TL-open. Nel complesso con la variante dP:Z*TP, la distribuzione si inverte, con l’ $80.6\%$ delle particelle in conformazione TL-open e il $19.4\%$ in conformazione TL-closed.
-
Coordinazione bimetallica e geometria del triplo fosfato: nel sito attivo pre-catalitico del complesso dZ:PTP, lo ione magnesio B ($\text{Mg}^{2+}$) presenta una coordinazione ottaedrica tridentata con i fosfati $\alpha$, $\beta$ e $\gamma$ del substrato. I residui Asp460, Asp462 e Asp464 della subunità $\beta’$ coordinano direttamente gli ioni metallici A e B.
Traduzione abstract. La disponibilità dello studio completo, in accesso libero o riservato, è verificabile tramite il link del DOI nel box sotto se disponibile.
Abstract
Gli alfabeti genetici espansi con nucleotidi sintetici possono aumentare notevolmente la diversità chimica degli acidi nucleici, consentendo nuove funzioni molecolari. Poiché la trascrizione cellulare è eseguita da RNA polimerasi multi-subunità, la compatibilità delle coppie di basi non naturali con questo macchinario è essenziale per la progettazione di sistemi genetici espansi. In questo studio dimostriamo che l’RNA polimerasi di Escherichia coli trascrive in modo efficiente un alfabeto genetico a otto lettere con due coppie di basi non naturali ortogonali: le coppie P:Z e B:S. Per superare l’errata incorporazione di G:Z, abbiamo sintetizzato un analogo ad alta fedeltà, denominato Z*, in cui il gruppo nitro in posizione C5 è stato sostituito con un gruppo carbossammidico. Per chiarire i meccanismi di riconoscimento del substrato, abbiamo determinato quattro strutture di RNA polimerasi contenenti dZ:PTP o dP:Z*TP mediante microscopia crioelettronica a una risoluzione di 2,42–2,75 Å. Queste strutture, insieme al nostro lavoro preliminare sulla coppia S:B, dimostrano che la RNA polimerasi di E. coli è in grado di riconoscere efficacemente queste coppie di basi non naturali nello stesso modo in cui riconosce le coppie di basi naturali. Nel complesso, questi risultati stabiliscono la fattibilità di un alfabeto genetico a otto lettere per la trascrizione.
“Structural basis of transcription of the hachimoji eight-letter alphabet by E. coli RNA polymerase” by Qingrong Li, Hyo-Joong Kim, Yan Liu, Juntaek Oh, Peini Hou, Shuichi Hoshika, Grigore Pintilie, Sriram Aiyer, Jenny Chong, Dmitry Lyumkis, Steven A. Benner and Dong Wang, 2 September 2026, Nature Communications.
DOI: 10.1038/s41467-026-76668-0


 by
