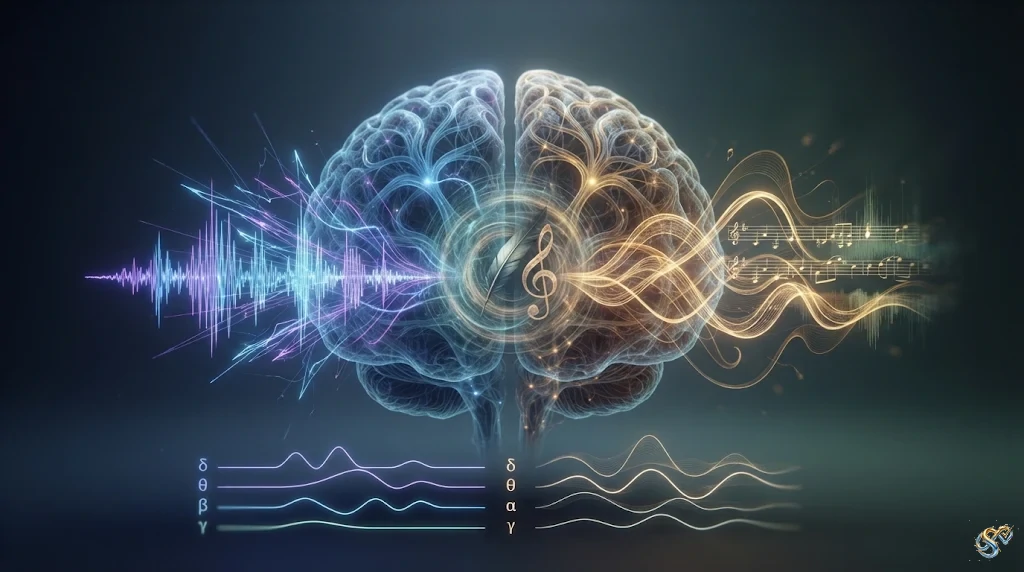
Immagina di guardare un film, giocare a un videogioco o ascoltare la radio in macchina. All’improvviso, mentre una voce parla, parte la musica in sottofondo, oppure i due suoni si alternano a ritmo serrato. Il tuo cervello non va in confusione, riconosce quasi all’istante chi sta parlando e quale melodia sta suonando. Una ricerca pubblicata su Science Advances, guidata da Jérémie Ginzburg, Robert J. Zatorre e Philippe Albouy, spiega che la corteccia uditiva riesce a compiere questa impresa sfruttando le modulazioni spettrotemporali, note con la sigla STM (Spectral Time Modulation). Per dimostrarlo in condizioni realistiche, i ricercatori hanno utilizzato la colonna sonora doppiata in francese di Harry Potter e la pietra filosofale.
Parole e note, due impronte acustiche diverse
Per capire come il cervello distingua parlato e musica, bisogna guardare al suono come a un’onda fatta di energia che cambia nel tempo e si distribuisce tra note alte e basse. Le modulazioni spettrotemporali descrivono proprio questo, cioè come il suono varia lungo due dimensioni principali:
-
Dimensione temporale, misura quanto velocemente cambia l’energia del suono nel tempo, misurata in hertz ($\text{Hz}$).
-
Dimensione spettrale, misura quanto sono fitti o dettagliati i cambiamenti di energia tra le diverse frequenze, misurata in cicli per kilohertz ($\text{cyc/kHz}$).
Nel parlato, il ritmo delle sillabe e dei fonemi crea variazioni rapide nel tempo. Lo studio mostra che per il parlato contano soprattutto le modulazioni temporali più veloci, con un picco tra 5,6 e 8,8 Hz, mentre le modulazioni spettrali restano basse, tra 0 e 0,4 cicli/kHz. Questo ritmo si avvicina alla cadenza naturale delle sillabe, che in molte lingue si muove intorno ai 4-7 Hz.
Nella musica, invece, il quadro si ribalta. Le note, gli accordi e i timbri degli strumenti creano schemi ricchi e dettagliati lungo le frequenze. Per la musica, i segnali più informativi si concentrano su un ampio ventaglio di modulazioni spettrali, con picchi intorno a 0,3, 1,2, 5,7, 6,5, 7,4 e 8,6 cicli/kHz, accompagnati da modulazioni temporali lente, tra 0 e 0,8 Hz, legate all’andamento più disteso delle frasi musicali.
| Aspetto analizzato | Parlato | Musica |
| Caratteristica principale |
Cambiamenti rapidi nel tempo |
Schemi dettagliati nelle frequenze |
| Modulazioni temporali (picchi) |
Circa 5,6-8,8 Hz (ritmo sillabico) |
Lente, intorno a 0-0,8 Hz |
| Modulazioni spettrali |
Basse, soprattutto 0-0,4 cicli/kHz |
Ampie, con picchi fino a 8,6 cicli/kHz |
| Emisfero con maggiore allineamento |
Sinistro |
Destro |
| Banda cerebrale più legata |
Gamma (bassa e alta) per il tempo |
Alfa per le frequenze |
Perché la colonna sonora di Harry Potter fa la differenza
Molti studi passati hanno fatto ascoltare ai partecipanti suoni brevi, isolati e artificiali, come una singola parola o una breve frase musicale staccata da tutto il resto. Nella vita di tutti i giorni, però, non funziona così: le voci si sovrappongono alla musica, si interrompono, cambiano volume e arrivano insieme ai rumori d’ambiente.
Utilizzando 7 minuti e 50 secondi della colonna sonora di Harry Potter e la pietra filosofale, il team ha messo alla prova il cervello con un ascolto continuo e naturale, in cui parlato e musica compaiono sia da soli sia sovrapposti. In un primo esperimento online, 19 adulti sani hanno ascoltato quel brano tenendo premuti i tasti della tastiera ogni volta che percepivano musica, voce o entrambe insieme. L’accordo tra i partecipanti è stato elevato, con un indice di Fleiss $\kappa$ pari a 0,69 per il parlato e 0,84 per la musica.
Quando i ricercatori hanno addestrato modelli informatici per prevedere le risposte delle persone partendo solo dalle modulazioni spettrotemporali della colonna sonora, l’accuratezza ha raggiunto il 97-99% per il parlato e il 99-100% per la musica. In più, i ricercatori hanno verificato il risultato su un brano separato e controllato di 10 minuti e 14 secondi, composto da un podcast in francese e da un brano per organo di Jehan Alain, alternati e sovrapposti in parti uguali, al 33% ciascuno per parlato solo, musica sola e sovrapposizione. Anche lì l’accuratezza è arrivata intorno al 99%.
Dentro il cervello, tra elettrodi, onde e due emisferi
Per osservare cosa accade davvero nel tessuto cerebrale mentre il suono scorre, i ricercatori hanno analizzato le registrazioni intracraniche (sEEG, stereoelettroencefalografia) di 11 pazienti con epilessia focale resistente ai farmaci, che ascoltavano passivamente la colonna sonora, senza dover premere pulsanti o classificare attivamente i suoni. Questo ha permesso di osservare la percezione naturale senza aggiungere lo sforzo mentale del compito di classificazione.
Dall’analisi di 846 contatti bipolari distribuiti tra i due emisferi, il team ha individuato 39 siti di registrazione, raggruppati in quattro cluster bilaterali in aree uditive non primarie, come il solco temporale superiore (STS), l’area A5 e le regioni belt. Ricostruendo le STM a partire dai segnali di quei singoli siti cerebrali, i modelli hanno previsto le scelte di categorizzazione del gruppo indipendente di ascoltatori con un’accuratezza del 54-60% per il parlato, in 36 contatti su 39, e del 54-71% per la musica, in tutti i 39 contatti, ben sopra il livello casuale del 50%.
Le onde cerebrali si dividono i compiti
Il cervello non usa un unico ritmo per seguire ogni aspetto del suono. Confrontando il peso delle diverse bande di oscillazione cerebrale, gli autori hanno osservato una doppia dissociazione molto netta:
-
Le onde più veloci nella banda gamma, sia bassa (26-50 Hz) sia alta (51-150 Hz), hanno contribuito di più al tracciamento delle modulazioni temporali, fondamentali per il parlato.
-
Le onde nella banda alfa (9-13 Hz) hanno contribuito di più al tracciamento delle modulazioni spettrali, decisive per la musica.
Secondo l’interpretazione degli autori, cicli oscillatori più brevi o più lunghi offrono scale temporali diverse per cogliere, da un lato, i cambiamenti rapidi nel tempo e, dall’altro, i dettagli più fini lungo le frequenze.
Sinistra per la voce, destra per la musica
Anche la lateralizzazione emisferica ha mostrato un schema chiaro. Quando i ricercatori hanno confrontato i profili di STM ricavati dal cervello con quelli estratti direttamente dalla colonna sonora, la somiglianza è risultata più forte nell’emisfero sinistro per il parlato e nell’emisfero destro per la musica. Ciò sostiene l’idea che le asimmetrie cerebrali nascano anche da diverse sensibilità alle modulazioni temporali e spettrali, oltre che da eventuali specializzazioni successive.
Cosa significa tutto questo per la vita di tutti i giorni e per la scienza
Per chi ascolta, questo studio chiarisce un punto fondamentale: il cervello non ha bisogno di attendere concetti astratti o complessi per iniziare a separare una voce da una melodia. Già il modo in cui la corteccia uditiva codifica il ritmo e la struttura delle frequenze del suono fornisce una base sufficiente per distinguere le due categorie, anche quando si mescolano in modo continuo.
Allo stesso tempo, gli autori sono prudenti e chiariscono cosa lo studio non dimostra. Dire che la codifica acustica delle STM è sufficiente per la distinzione tra parlato e musica non significa che sia l’unico meccanismo esistente. In fasi successive o in aree associative di ordine superiore, il cervello può aggiungere analisi più raffinate, per esempio per riconoscere singole parole, melodie precise, canzoni o aspettative su ciò che sta per arrivare. Inoltre, nessuno dei pazienti aveva elettrodi nella corteccia uditiva primaria, e il percorso uditivo inizia già nelle strutture sottocorticali, come il collicolo inferiore e il corpo genicolato mediale.
Approfondimenti tecnici dal documento
Estrazione del modulogramma e parametrizzazione dello spazio STM
Nel protocollo principale, il segnale audio stereo della colonna sonora di Harry Potter (campionato a 48 kHz) è stato analizzato tramite l’algoritmo ModFilter, estraendo 512 modulogrammi al secondo in corrispondenza della frequenza di campionamento delle registrazioni sEEG (512 Hz, con filtro hardware passa-banda 0,1-200 Hz e frequenza di Nyquist di 256 Hz). Per ogni istante temporale, è stata applicata una finestra scorrevole di 1,5 s a partire dal campione corrente, calcolando una trasformata veloce di Fourier bidimensionale (2D FFT) sulla matrice di autocorrelazione della rappresentazione spettrografica.
Le matrici ottenute dai due canali stereo sono state mediate nello spazio STM, e i valori di modulazione temporale negativa sono stati mediati con i corrispondenti valori positivi data la simmetria tipica di parlato e musica. Questo ha prodotto, per ciascun campione temporale, 2.180 combinazioni spettrotemporali, date da 109 punti di modulazione spettrale (0-9 cicli/kHz) per 20 punti di modulazione temporale (0-15 Hz). Nell’analisi complementare con il brano controllato (campionato a 44,1 kHz, 10 min 14 s, segmenti con durata campionata da una distribuzione normale troncata con $\mu = 32\text{ s}$, $\sigma = 4\text{ s}$, vincolata tra 24 e 40 s, normalizzati in RMS e compressi con il compressore FAST attack di REAPER), la griglia ha compreso 20 punti temporali per 100 punti spettrali, pari a 2.000 combinazioni.
Preelaborazione sEEG, trasformata di Hilbert e modelli TRF con ridge regression
I 11 pazienti della coorte principale (4 femmine, età media 29,6 anni, $\text{SD} = 3,2\text{ anni}$, madrelingua francesi canadesi) sono stati impiantati stereotassicamente con 16-18 elettrodi semirigidi (AdTech, diametro 0,8 mm, contatti larghi 2,0 mm con spaziatura di 3, 4, 5 o 6 mm). La localizzazione è avvenuta coregistrando la TC post-impianto alla RM anatomica 3T T1-pesata pre-impianto (MPRAGE, 160 sezioni sagittali, voxel isotropi da $1\text{ mm}^3$) tramite il toolbox ImaGIN, normalizzando in spazio MNI con SPM e assegnando le etichette anatomiche tramite l’atlante HCP multimodale esteso. La coorte complementare ha incluso 5 pazienti (tutte femmine, età media 31,8 anni, $\text{SD} = 11,1\text{ anni}$).
Dopo la rimozione dei contatti con attività epilettica patologica o artefatti, l’elaborazione in Brainstorm ha incluso un filtro notch a 60 Hz e armoniche (120 e 180 Hz), segmentazione da -10 a 490 s rispetto all’inizio della traccia e ri-riferimento bipolare verso il contatto adiacente, riducendo la conduzione di volume e raggiungendo una risoluzione spaziale stimata di 3-4 mm, per un totale di 846 contatti bipolari (51,4% a sinistra, 48,6% a destra; 47-88 contatti per paziente). Mediante trasformata di Hilbert e normalizzazione z-score temporale, è stata estratta l’ampiezza dell’inviluppo in sei bande:
-
Delta, 0,5-3 Hz
-
Theta, 4-8 Hz
-
Alfa, 9-13 Hz
-
Beta, 14-25 Hz
-
Gamma bassa, 26-50 Hz
-
Gamma alta, 51-150 Hz
Sia i predittori neurali sia i target STM sono stati ricampionati a 50 Hz. Modelli di ridge regression con funzione di risposta temporale (TRF) in approccio inverso (ritardi temporali da 0 a 1,5 s) sono stati valutati tramite validazione incrociata a 10 fold su 20 valori logaritmici del parametro di regolarizzazione da $10^{-10}$ a $10^{10}$, usando la correlazione di Spearman ($\rho$) tra serie temporali predette e osservate.
Soglie statistiche, clustering spaziale, trasformazione di Haufe e test ART
Per identificare i contatti sensibili alle STM, i coefficienti $\rho$ sono stati trasformati con Fisher $z$ e sottoposti a test $t$ a una coda contro zero. A fronte di circa $1,8 \times 10^7$ confronti (soglia Bonferroni $\sim 2,7 \times 10^{-9}$), è stata applicata una soglia conservativa fissa di $\alpha = 10^{-30}$, richiedendo almeno sei valori $\rho$ significativi adiacenti nello spazio STM 2D. Per il clustering spaziale, sfere tridimensionali con raggio di 5 mm in spazio MNI (proiettate con MarsBar) hanno definito cluster significativi solo in presenza di almeno due contatti sovrapposti provenienti da almeno tre pazienti differenti, isolando quattro cluster (39 contatti totali: 11 anteriori e posteriori a sinistra, 13 anteriori e 15 medio-posteriori a destra).
Per collegare STM e categorizzazione binaria (0/1) dei 19 soggetti comportamentali (20 reclutati online su Pavlovia con PsychoPy, 11 femmine, età media 36,4 anni, $\text{SD} = 14,7\text{ anni}$, 1 escluso per problema tecnico sul server), sono stati addestrati modelli separati di regressione logistica con validazione incrociata stratificata a 5 fold. I pesi del modello sono stati convertiti tramite trasformazione di Haufe per ottenere pattern interpretabili nello spazio delle caratteristiche, evitando l’interpretazione diretta dei pesi grezzi.
Il contributo delle bande oscillatorie è stato valutato estraendo i pesi della ridge regression sulle combinazioni STM dentro il 90° percentile delle maschere di regressione logistica (dimensione temporale per il parlato, spettrale per la musica), normalizzandoli con z-score tra le bande e mediandoli su combinazioni e ritardi. Un ANOVA fattoriale non parametrica $6 \times 2$ con metodo Aligned Rank Transform (ART) su bande e dimensioni ha mostrato un effetto principale della banda ($F_{5,418} = 7,24$, $P < 0,001$) e un’interazione banda per dimensione ($F_{5,418} = 53,89$, $P < 0,001$), con test post hoc di Wilcoxon corretti con FDR.
Infine, la somiglianza tra i pattern estratti dalle STM ricostruite dal cervello e da quelle acustiche reali (su 19 confronti per categoria ed emisfero, ciascuno significativo a $P < 0,001$ con correzione di Bonferroni e diverso dalle distribuzioni con etichette mescolate, entrambi $P = 2,9 \times 10^{-22}$) è stata analizzata con un ART $2 \times 2$ su categoria (parlato/musica) ed emisfero (sinistro/destro). L’analisi ha evidenziato un effetto principale della categoria ($F_{1,55,65} = 72,20$, $P < 0,001$), nessun effetto principale dell’emisfero ($F_{1,55,65} = 0,68$, $P = 0,412$) e un’interazione categoria per emisfero significativa ($F_{1,55,65} = 23,64$, $P < 0,001$), con somiglianza maggiore a sinistra per il parlato ($P = 0,027$ FDR) e a destra per la musica ($P < 0,001$ FDR).
Traduzione o Sintesi divulgativa dell’abstract ai sensi del Diritto di Citazione per fini di discussione e divulgazione scientifica (art. 70 L. 633/1941). La disponibilità dello studio completo, in accesso libero o riservato, è verificabile tramite il link del DOI nel box sottostante.
Abstract
L’elaborazione uditiva viene tipicamente descritta come gerarchica, culminante nella rappresentazione neurale di categorie astratte. Tuttavia, non è ancora chiaro se le risposte selettive per categoria nella corteccia uditiva richiedano meccanismi rappresentazionali che vadano oltre la codifica delle caratteristiche acustiche o se le rappresentazioni acustiche già disponibili nella corteccia uditiva siano sufficienti a spiegare la categorizzazione. In questo studio, verifichiamo se la codifica corticale delle caratteristiche di modulazione spettrotemporale (STM) sia sufficiente a supportare la categorizzazione del parlato e della musica, combinando registrazioni intracraniche umane con giudizi comportamentali continui di una colonna sonora naturalistica in cui parlato e musica si presentano sia separatamente che simultaneamente. Dimostriamo che i pattern di modulazione temporale e spettrale caratterizzano in larga misura rispettivamente il parlato e la musica, e che le regioni uditive corticali tracciano in modo robusto queste caratteristiche nel tempo, con bande di frequenza oscillatoria distinte che codificano preferenzialmente le modulazioni temporali e spettrali. In particolare, le rappresentazioni corticali delle STM hanno predetto i giudizi categoriali percettivi raccolti in un campione indipendente. Infine, le rappresentazioni STM relative al parlato e alla musica hanno mostrato un tracciamento più forte delle caratteristiche acustiche specifiche della categoria nelle regioni uditive corticali di sinistra rispetto a quelle di destra, rispettivamente. Questi risultati indicano che l’efficiente codifica neurale delle caratteristiche acustiche fornisce una base sufficiente per la distinzione categoriale tra parlato e musica e che le componenti temporali e spettrali di questa rappresentazione sono implementate attraverso meccanismi oscillatori distinti.
Jérémie Ginzburg et al., Auditory cortical coding of spectrotemporal modulations is sufficient to support perceptual categorization of speech and music, Science Advances (2026). DOI: 10.1126/sciadv.aed8025


 by
